
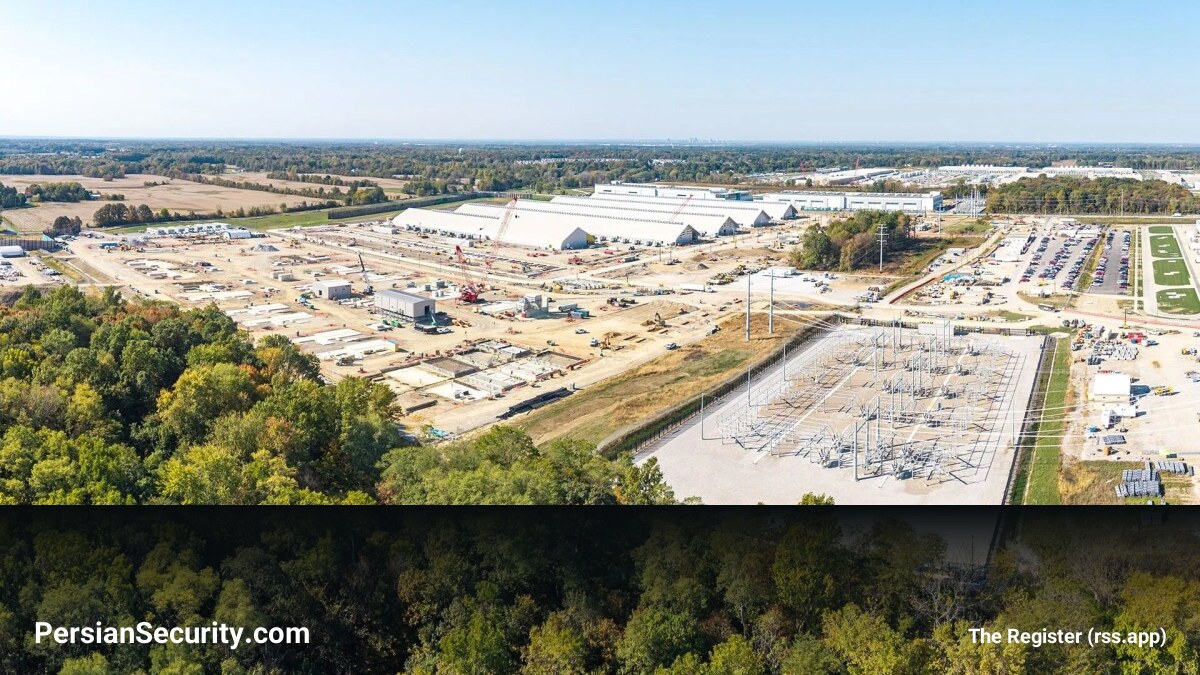
متا (Meta) در هفته جاری فاش کرد که بیش از ۱۱ درصد از پردازندههای گرافیکی (GPU) در ابررایانهی Prometheus واقع در اوهایو، یا از کار افتادهاند و یا در حالت آمادهباش (Idle) قرار دارند تا در صورت بروز خرابی در سایر واحدها، جایگزین شوند. این حجم از پردازندههای رزرو، بخشی از استراتژی این ابرمقیاس (Hyperscaler) برای حفظ پایداری فرآیند آموزش مدلهای هوش مصنوعی است.
چالش مقیاسپذیری در خوشههای محاسباتی بزرگ
با افزایش تعداد تراشهها در خوشههای محاسباتی بزرگ، چه برای آموزش مدلهای زبانی بزرگ (LLM) و چه برای پردازشهای سنتی (HPC)، احتمال خرابی سختافزار به طور اجتنابناپذیری افزایش مییابد. در یک کلاستر با ۱۰۰,۰۰۰ پردازنده گرافیکی، خرابیها یک واقعیت همیشگی هستند. متا در حال ساخت زیرساختی است که ۱۰ برابر بزرگتر از موارد فعلی بوده و نیاز به آموزش توزیعشده (Distributed Training) در چندین مرکز داده را دارد. حفظ پایداری این سیستم برای رسیدن به نقاط بازگشت (Checkpoint) بعدی، یک چالش مهندسی بسیار بزرگ است.
راهکارهای متا برای مقابله با توقفهای سیستم
متا برای جلوگیری از توقف فرآیند توسعه مدلهایی مانند Muse Spark، چندین راهکار فنی را پیادهسازی کرده است:
- استفاده از قطعات رزرو (Hot Spares): در سیستمهای مبتنی بر Blackwell انویدیا، متا از ترکیب ۷۲ پردازنده گرافیکی در هر دامنه NVLink استفاده میکند، اما تنها ۶۴ عدد از آنها در هر لحظه در حال فعالیت هستند. ۸ پردازنده باقیمانده به عنوان قطعات رزرو (Hot Spares) عمل میکنند تا در صورت خرابی یک واحد، کل رک (Rack) از مدار خارج نشود و فرآیند آموزش با کمترین وقفه ادامه یابد.
- موازیسازی دادهها (Data Parallelism): با استفاده از این تکنیک، متا میتواند خرابی یک کپی از مدل را ایزوله کرده و تنها همان بخش آسیبدیده را از دسترس خارج کند، بدون اینکه کل فرآیند آموزش متوقف شود. بخش آسیبدیده مجدداً روی میزبانهای رزرو راهاندازی و همگامسازی (Resynchronize) میشود.
- معماری ذخیرهسازی وضعیت (Distributed Checkpointing): این معماری به صورت ناهمگام (Asynchronous) وضعیت مدل — شامل گرادیانها (Gradients) و دادههای بهینهساز (Optimizer data) — را در ذخیرهسازهای چندلایه ذخیره میکند تا در صورت بروز خطا، نیاز به شروع مجدد از صفر نباشد.
موانع فنی: سیگنال و نوسانات توان
یکی از بزرگترین چالشها، مدیریت اتصالهای NVLink است. با وجود بیش از ۶۰۰,۰۰۰ اتصال NVLink، حتی کوچکترین افت سیگنال میتواند باعث چرخههای بازیابی مکرر شود. همچنین، نوسانات شدید مصرف توان (Power Transients) ناشی از بالا و پایین رفتن ناگهانی فعالیت هزاران GPU، میتواند تجهیزات منبع تغذیه را تحت فشار قرار دهد. با مدیریت این چالشها، متا توانسته است به نرخ Goodput (نرخ خروجی مفید) بیش از ۸۵ درصد در پیشآموزش (Pretraining) دست یابد.


