
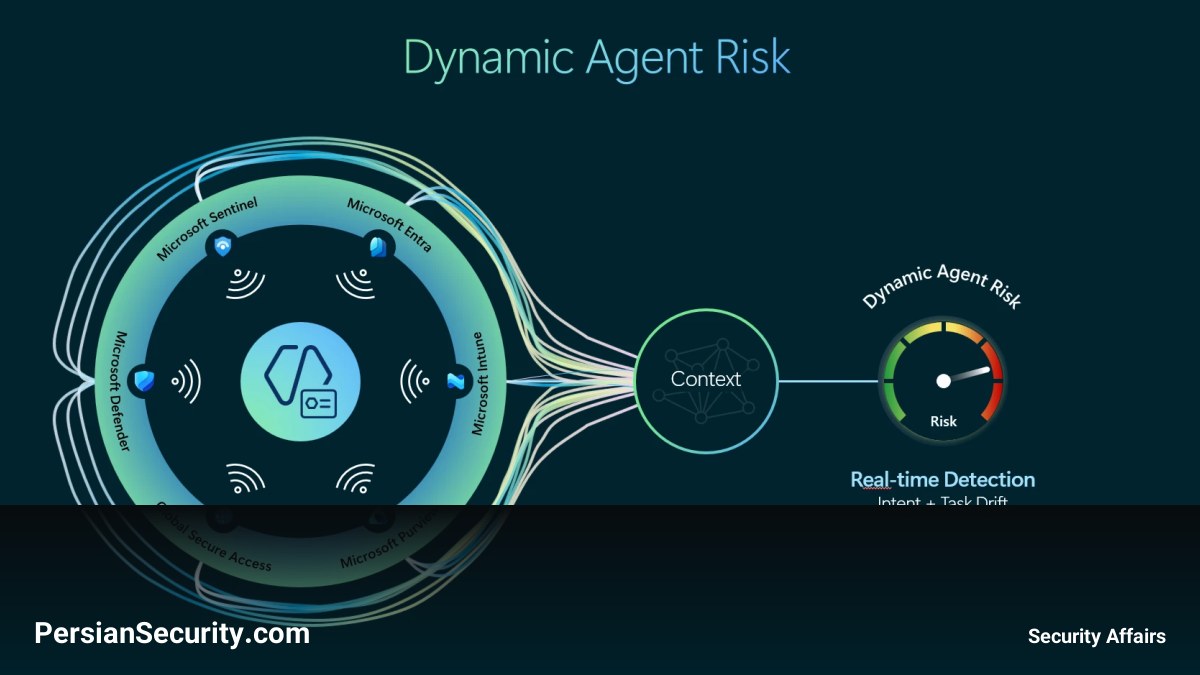
مایکروسافت از سازمانها میخواهد که برای امنیت عاملهای هوش مصنوعی (AI Agents)، با آنها مشابه تهدیدات داخلی (Insider Threats) برخورد کنند. این شرکت پیشنهاد میدهد که از مجوزهای پویا (Dynamic Permissions)، پایش مستمر ریسک (Continuous Risk Monitoring) و مهار خودکار (Automated Containment) برای مدیریت این عاملها استفاده شود.
از دیدگاه مایکروسافت، عاملهای هوش مصنوعی ذاتاً خطرناک نیستند، اما به دلیل دسترسی به سیستمهای حیاتی، ممکن است دچار خطا شوند، مورد دستکاری قرار گیرند یا کاملاً تسخیر (Compromised) شوند. ساتیا نادلا، مدیرعامل مایکروسافت، معتقد است که امنترین سیستمهای مبتنی بر عامل، آنهایی نیستند که مدلهای آنها را بیش از همه میپذیریم، بلکه آنهایی هستند که به گونهای طراحی شدهاند که اجازه میدهند کمترین میزان اعتماد را به مدل داشته باشیم.
چالش انحراف رفتاری و تزریق دستور (Prompt Injection)
یکی از خطرات اصلی، تغییر بافت (Context) عامل در حین انجام کار است. برای مثال، یک حمله تزریق دستور (Prompt Injection) در یک سند خارجی یا دادههای غیرقابل اعتماد میتواند استدلال عامل را تغییر دهد. این اتفاق لزوماً به معنای هک شدن سنتی عامل نیست، بلکه باعث میشود رفتار عامل از مسیر تعیینشده خارج شود (Behavioral Drift). از آنجایی که این فرآیند با سرعت ماشین انجام میشود، زمان واکنش بسیار کوتاه است.
راهکارهای پیشنهادی: مجوزهای پویا و پایش ریسک
مایکروسافت دو مفهوم کلیدی را برای مقابله با این تهدیدات معرفی میکند:
- مجوزهای پویا (Dynamic Permissions): اعمال اصل حداقل دسترسی (Least Privilege) به صورت اختصاصی برای هر عامل. یک عامل نباید همان سطح دسترسی کارمند مستقرکننده خود را داشته باشد، بلکه باید تنها برای مدت زمان انجام وظیفه و تنها با دسترسیهای مورد نیاز، هویت و مجوزهای مستقل داشته باشد.
- ریسک پویا در عامل (Dynamic Agent Risk): امتیاز ریسکی که به طور مداوم از طریق سیگنالهای هویت، نقاط پایانی (Endpoints)، شبکه، ابر (Cloud) و رفتار خود عامل بهروزرسانی میشود. در صورت افزایش ریسک، اقدامات حفاظتی به صورت مرحلهای (Graduated Response) انجام میشود؛ مثلاً محدود کردن دسترسی به حالت “فقط خواندنی” یا نیاز به تأیید انسانی برای مراحل حساس.
شناسایی عاملهای پنهان و عاملهای نگهبان (Guardian Agents)
بسیاری از سازمانها با عاملهایی مواجه هستند که از طریق ابزارهای شخص ثالث (Third-party) وارد سازمان شده و در سیستمهای مرکزی ثبت نشدهاند. مایکروسافت قصد دارد قابلیت شناسایی (Discovery) را برای ۶۰ نوع عامل محلی از جمله Claude Code، OpenAI Codex و GitHub Copilot گسترش دهد.
علاوه بر این، برای مدیریت حجم بالای هشدارها، مفهوم عاملهای نگهبان (Guardian Agents) معرفی شده است. اینها عاملهای هوش مصنوعی هستند که وظیفه نظارت امنیتی، بررسی تغییرات ریسک و اجرای دستورالعملهای امنیتی (Playbooks) را بر عهده دارند. با این حال، این رویکرد خود چالشی ایجاد میکند: از آنجایی که نگهبانان نیز هوش مصنوعی هستند، خودشان نیز در معرض دستکاری قرار دارند. مایکروسافت تأکید میکند که کنترلهای امنیتی باید خارج از مدل هوش مصنوعی عمل کنند تا از پایداری آنها اطمینان حاصل شود.
بهروزرسانی (اکتبر 20, 2026 — SecurityWeek)
بهروزرسانی: مایکروسافت جزئیات بیشتری از قابلیتهای جدید خود برای پایش و محدودسازی عاملهای هوش مصنوعی (AI Agents) در محیطهای سازمانی منتشر کرده است. این استراتژی بر این اصل استوار است که این عاملها باید به عنوان «تهدیدات داخلی» (Insider Threats) مدیریت شوند، نه صرفاً به عنوان نرمافزارهای قابل اعتماد.
قابلیتهای جدید معرفی شده شامل موارد زیر است:
- Dynamic Permissions (مجوزهای پویا): در این حالت، عاملها در ابتدا هیچ دسترسی یا حداقل دسترسی ممکن را دارند و دسترسیها تنها بر اساس هر تسک (Task) اعطا شده و پس از پایان کار منقضی یا محدود میشوند. همچنین اقدامات با تاثیر بالا نیازمند بررسی انسانی هستند.
- Dynamic Agent Risk (ریسک پویا برای عاملها): اختصاص یک امتیاز ریسک (Risk Score) به هر عامل که به صورت مستمر بر اساس فعالیت، هویت، دادهها، نقاط پایانی (Endpoints) و سیگنالهای شبکه و ابری بهروزرسانی میشود.
- Dynamic Conditional Access (دسترسی مشروط پویا): ادغام با Entra Conditional Access برای واکنش به تغییرات ریسک؛ برای مثال، کاهش سطح دسترسی از حالت نوشتن به خواندن، محدود کردن منابع شبکه یا نیاز به تایید انسانی برای اقدامات حساس. در صورت بالا رفتن ریسک، اجرای عامل میتواند متوقف یا ایزوله شود.
- Playbooks و Guardian Agents: استفاده از دستورالعملهای خودکار (Playbooks) و عاملهای نگهبان (Guardian Agents) برای اجرای پاسخهای امنیتی، بررسی علت تغییر سطح ریسک و اعمال محدودیتها.
همچنین، محدوده پوشش Project Perception گسترش یافته و اکنون از ۶۰ نوع عامل مختلف، از جمله Claude Code، OpenAI Codex و GitHub Copilot پشتیبانی میکند.


