
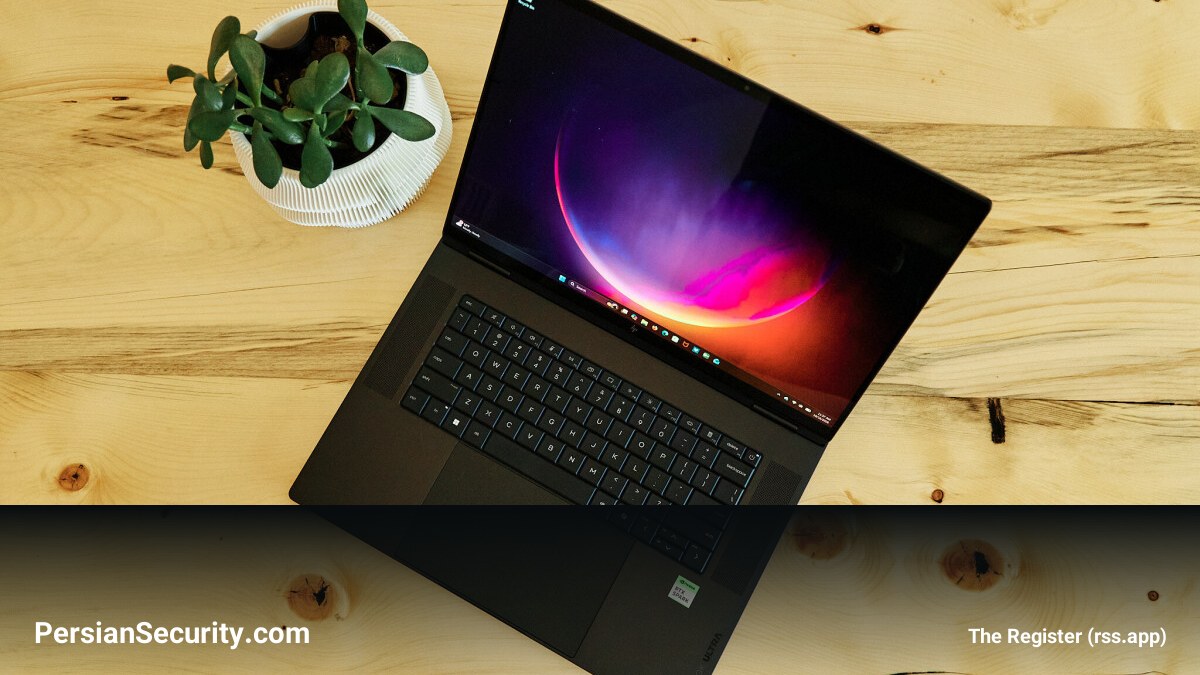
پلتفرم جدید RTX Spark از شرکت Nvidia با هدف ارائه توان پردازشی بالا برای اجرای مدلهای هوش مصنوعی به صورت محلی (Local AI) معرفی شده است. یکی از اولین نمونههای پیادهسازی شده در این پلتفرم، لپتاپ OmniBook Ultra 16 محصول شرکت HP است که از تراشه قدرتمند N1X بهره میبرد.
سختافزار و معماری تراشه N1X
قلب تپنده این دستگاه، SoC مدل N1X است که ترکیبی از یک CPU مبتنی بر MediaTek و یک GPU از معماری Blackwell است که از طریق رابط اتصال NVLink Fusion به یکدیگر متصل شدهاند. این تراشه در دو نسخه عرضه میشود: نسخه پایه با ۱۸ هسته CPU و ۵۱۲۰ هسته CUDA، و نسخه پیشرفته با ۲۰ هسته CPU و ۶۱۴۴ هسته CUDA که از نظر تعداد هستههای گرافیکی با RTX 5070 برابری میکند.
یکی از برجستهترین ویژگیهای این سیستم، دسترسی به حافظه یکپارچه (Unified Memory) تا سقف ۱۲۸ گیگابایت است. این حجم از حافظه برای اجرای مدلهای زبانی بزرگ (LLM) که نیاز به VRAM زیادی دارند، حیاتی است و امکان جایگزینی ابزارهای ابری مانند Claude Code یا Codex را با نسخههای محلی فراهم میکند.
تحلیل عملکرد در پردازش هوش مصنوعی
در بنچمارکهای انجام شده با استفاده از فریمورک Llama.cpp روی مدلهای مختلف Meta، گوگل و Alibaba، نتایج زیر به دست آمده است:
- سرعت تولید توکن (Token Generation): به دلیل پهنای باند حافظه ۳۰۰ گیگابایت بر ثانیه، این دستگاه در تولید توکنها عملکرد بسیار خوبی دارد.
- زمان تا اولین توکن (TTFT): این معیار که نشاندهنده قدرت پردازشی GPU در تحلیل Prompt است، در مدلهای کوچکتر بسیار سریع و در مدلهای بزرگتر (تا ۱۲۲ میلیارد پارامتر) به طور متناسب کاهش مییابد.
- هوش مصنوعی عاملمحور (Agentic AI): در تستهای کدنویسی، مشاهده شد که مدلهای بزرگتر (مانند Qwen3.5-122B) هرچند توکنها را کندتر تولید میکنند، اما به دلیل هوشمندی بیشتر و نیاز به توکنهای کمتر برای حل مسئله، در نهایت سریعتر از مدلهای کوچکتر به پاسخ نهایی میرسند.
چالشهای حرارتی و عملیاتی
با وجود قدرت پردازشی بالا، سیستم مدیریت حرارتی در بدنه باریک این لپتاپ با چالش مواجه است. در بارهای کاری مداوم استنتاج (Inference)، دمای GPU به بیش از ۹۰ درجه سلسیوس میرسد که منجر به بروز محدودیت حرارتی (Thermal Throttling) و در برخی موارد، ایجاد Artifactهای گرافیکی یا هنگ کردن سیستم میشود.
همچنین، مدیریت حافظه در محیط ویندوز به اندازه لینوکس بهینه نیست و به صورت پیشفرض حافظه بین CPU و GPU تقسیم میشود، هرچند ابزارهایی مانند Llama.cpp میتوانند این محدودیت را با استفاده از حافظه CPUe تعدیل کنند.
جمعبندی برای مدیران IT و متخصصین امنیت
لپتاپهای RTX Spark برای کاربران عادی توصیه نمیشوند، اما برای پژوهشگران AI و متخصصین امنیتی که نیاز به اجرای مدلهای حساس روی سختافزار محلی (به دلیل مسائل حریم خصوصی و امنیت دادهها) دارند، گزینهای قدرتمند هستند. با این حال، قیمت بسیار بالا (از ۲۶۰۰ تا بیش از ۶۰۰۰ دلار) و مشکلات حرارتی، این دستگاه را به یک محصول تخصصی (Niche) تبدیل کرده است.


